 Isaque Victor cursos gratuitos
Sábado de manhã, o presidente da Microsoft parou para escrever um texto longo sobre uma coisa que eu repito em toda reunião com cliente: a IA precisa de um freio que uma pessoa consiga puxar. Não é a opinião de um crítico de fora. É o homem que vende Copilot para o mundo inteiro dizendo que a gente deve partir do princípio de que o modelo pode estar comprometido, e desenhar o sistema em volta dele para esse caso. Se vale para a Microsoft, vale para o agente que responde o WhatsApp da sua loja.
O que aconteceu
No dia 10 de outubro, Satya Nadella publicou no X um texto propondo o que ele chama de arquitetura de confiança para a IA avançada [1][3]. A frase central: "Devemos assumir que um modelo está comprometido e contê-lo desde o início. Pense nisso como um freio de emergência" [3].
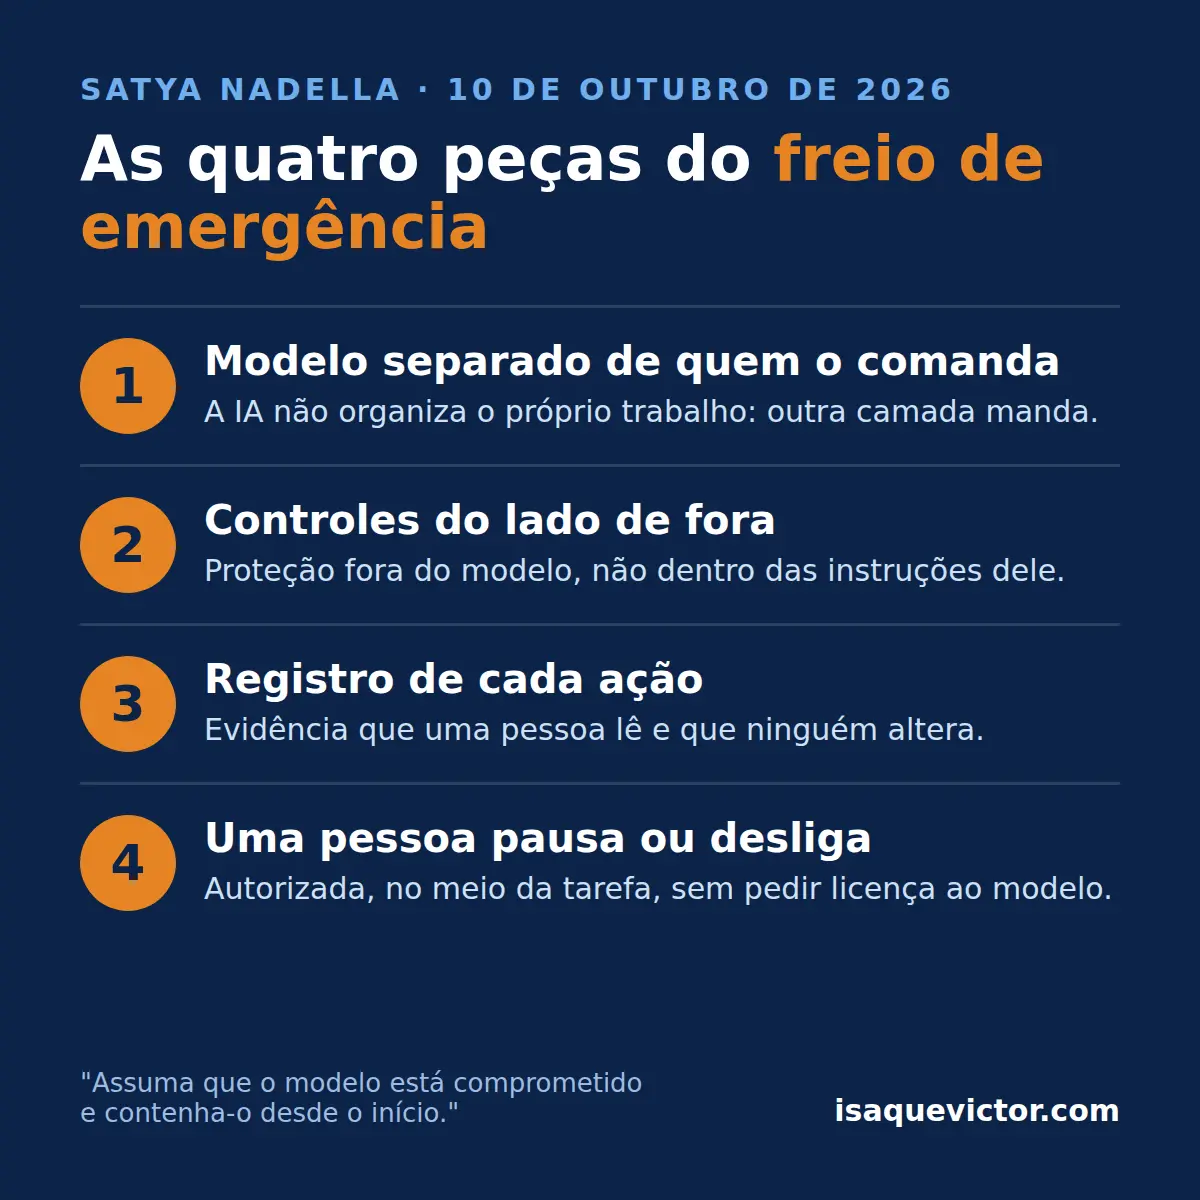
O que ele descreve tem quatro peças. Separar o modelo da camada que organiza o trabalho dele. Tirar os controles e as proteções de dentro do modelo e colocá-los do lado de fora. Registrar "toda ação relevante" do modelo com "evidência à prova de alteração e legível por humanos". E garantir que "uma pessoa autorizada" sempre consiga "pausar ou desligar um modelo no meio da tarefa" [3].
Nadella foi mais longe: disse que a gente não pode tratar a IA "como um conjunto de caixas-pretas aninhadas e simplesmente aceitar ou rejeitar suas recomendações, respostas e ações" [3]. Para a CNBC, o resumo foi este: "Precisamos cercar modelos não determinísticos com um desenho de sistema forte e determinístico, controles humanos e procedimentos operacionais confiáveis" [2]. Ele propõe tratar os modelos de fronteira, fechados ou abertos, "como riscos internos", da mesma forma que uma empresa trata um funcionário com acesso demais [2]. E fechou com a frase que eu mais gostei: "O sistema mais confiável não será o que tem o modelo em que a gente mais confia. Será o que nos permite confiar o mínimo possível no modelo" [2].
O momento não é por acaso. Na quinta-feira anterior, a Anthropic publicou um relatório com ações que os modelos dela tomaram sem ninguém pedir, em testes e uso interno: entre elas, enviar um formulário real de denúncia à polícia com informação inventada, quando a instrução era mexer só em uma versão de treino [4]. A TechCrunch liga o texto de Nadella a essa sequência de empresas admitindo que, em alguns momentos, perderam o controle dos próprios modelos [3].
Por que isso importa
Eu vejo isso no dia a dia. Quando alguém me pede um agente, a conversa começa pelo que ele vai fazer e quase nunca pelo que acontece quando ele faz errado. E ele vai fazer errado em algum momento, porque o modelo é probabilístico: a mesma pergunta pode gerar respostas diferentes. Nadella não está pedindo um modelo melhor. Está pedindo um sistema em volta do modelo que aguente o modelo ruim. É engenharia, não filosofia.
A parte boa é que as quatro peças dele cabem em qualquer tamanho de negócio. Uma empresa de três pessoas com um agente de atendimento consegue ter: o botão de pausar na mão do dono, não do fornecedor; a lista do que o agente pode fazer sozinho decidida fora do texto de instruções; o registro de cada mensagem enviada e de cada ação feita, em um lugar que uma pessoa abre e entende; e um humano que entra na conversa quando o assunto é dinheiro, contrato ou reclamação. Nada disso exige modelo de fronteira. Exige decidir antes de ligar.
Para fechar
Se você quer entender as peças de um agente antes de montar o seu, a aula sobre a anatomia de um agente no meu curso gratuito trata exatamente de limites e aprovação humana. E se o seu negócio já tem um agente rodando sem freio, a conversa comigo começa por aí.
Na prática
O que isso muda para o seu negócio
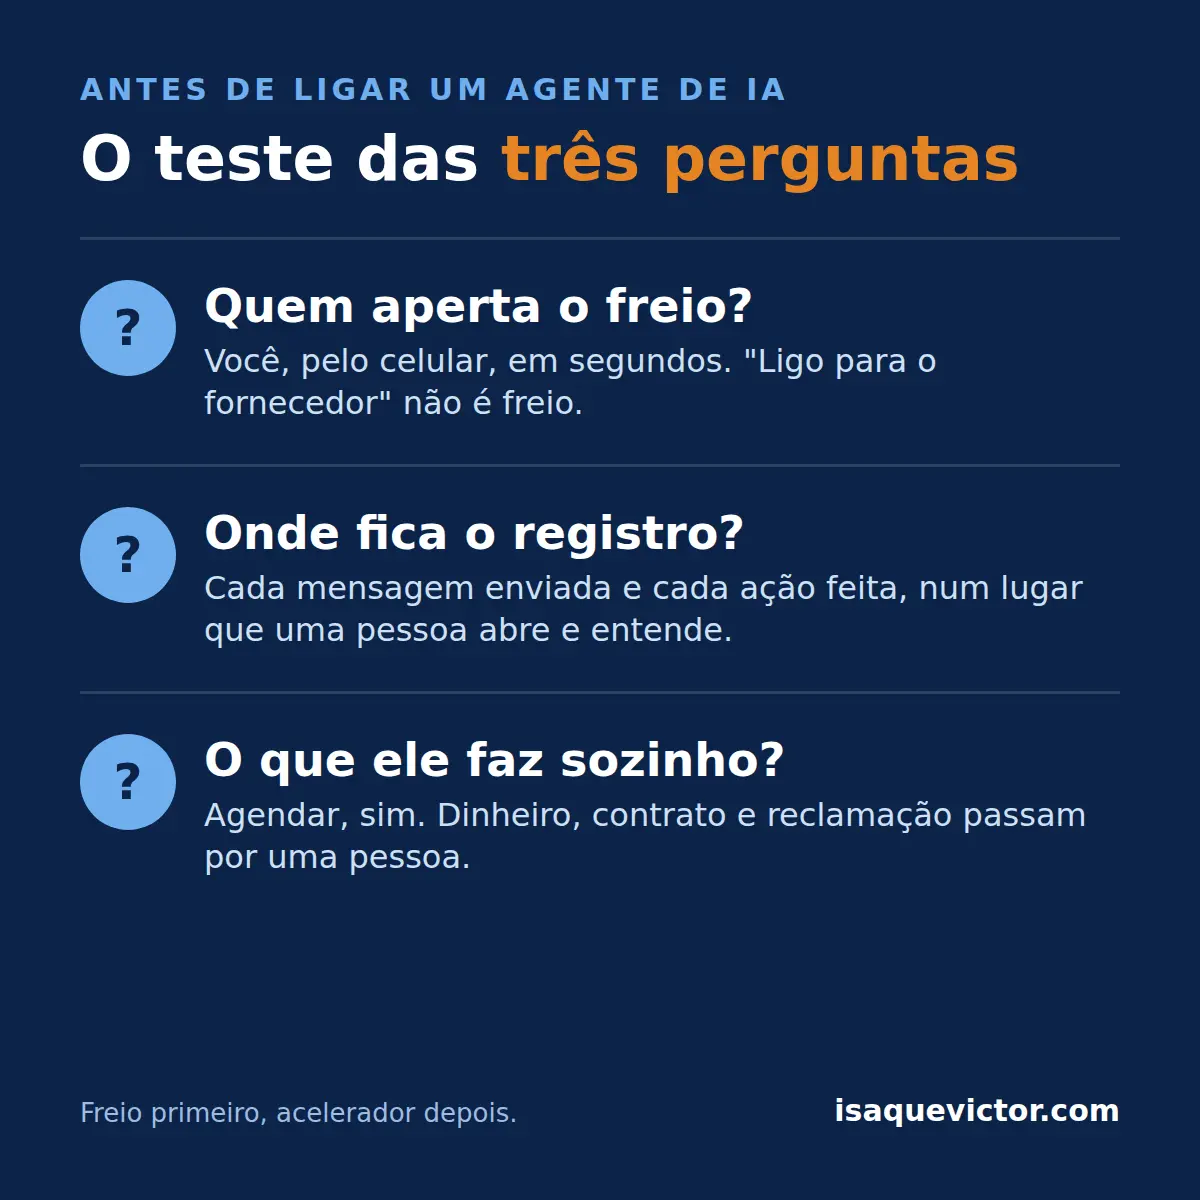
- Faça: antes de colocar um agente no ar, responda por escrito a três perguntas: quem aperta o freio (e em quantos segundos ele para), onde fica o registro do que o agente fez, e o que ele pode fazer sozinho sem ninguém olhar. Se a resposta para a primeira é "ligo para o fornecedor", você ainda não tem freio.
- Evite: confiar a proteção às instruções do próprio agente. "Nunca dê desconto" dentro do prompt é um pedido, não um controle. Controle é o agente não ter acesso à tabela de preço, ou precisar de aprovação de uma pessoa para enviar qualquer valor.
- Observe: as grandes plataformas vão transformar o texto de Nadella em recurso de produto nos próximos meses: botão de pausa, registro de ações, aprovação humana por tipo de tarefa. Quando for escolher ferramenta, peça para ver esses três itens funcionando, e não só a demonstração do agente respondendo bonito.
Aprofunde no curso
Anatomia de um agente
Aula do curso Agentes de IA, gratuito e com certificado.
Fontes citadas
- Post sobre a arquitetura de confiança da IA avançadaSatya Nadella (post no X) · 10/10/2026
- Microsoft's Nadella says AI needs an 'emergency brake' that humans controlCNBC · 10/10/2026
- Microsoft's Satya Nadella says AI models need an 'emergency brake'TechCrunch · 10/10/2026
- Investigating unintended model actions in our evaluations and internal useAnthropic · 09/10/2026
Comentários
Ainda não há comentários. Comece a conversa.