 Isaque Victor cursos gratuitos
Quase toda empresa pequena que eu conheço vende pelo Instagram, pelo Facebook ou pelo WhatsApp, e quase todas colocam o link do próprio site na bio, no catálogo ou no anúncio. A Meta publicou uma versão nova dos Termos Comerciais, que vale a partir de 30 de outubro de 2026, e uma das mudanças mexe exatamente com esse site: ela passa a ter autorização expressa para ler o conteúdo dele com robôs e usar esse conteúdo para treinar os próprios produtos. Eu li a cláusula na página da Meta. Não dá para recusar só essa parte, e por isso vale decidir antes da data.
O que aconteceu
Atualização 18/10
Depois da publicação, a Meta mudou a redação desta cláusula na versão em inglês da prévia dos termos, que consultei em 18/10 [4]. A frase que permitia usar o conteúdo do site para "treinar" os produtos da Meta saiu. Agora o texto diz que a leitura automática serve para fornecer, desenvolver, melhorar, pesquisar e manter os produtos de publicidade e de negócios da Meta e para manter a integridade e a segurança dos produtos dela [4]. A autorização para os robôs lerem o site continua, e a data de vigência segue 30 de outubro [4]. Na mesma data, a versão em português da página ainda mostrava o texto anterior, que é o descrito abaixo [1]. A decisão sobre o robots.txt continua valendo, porque a documentação oficial dos robôs da Meta ainda descreve o Meta-ExternalAgent como o rastreador usado em casos como treinar modelos de IA [3].
Na parte sobre as licenças que a empresa concede à Meta, a versão nova diz que o usuário autoriza a Meta, ou quem age em nome dela, a usar software automatizado, "como web scrapers, bots, robôs, spiders, rastreadores e agentes de usuário", para acessar, indexar, guardar em cache, analisar e coletar domínios, páginas e endereços associados aos produtos e serviços da empresa ou disponibilizados por meio dos produtos da Meta [1]. Em seguida, o texto diz que a Meta pode usar qualquer conteúdo dessas páginas para "fornecer, desenvolver, melhorar, pesquisar, treinar e manter a integridade" dos seus produtos [1]. A aceitação é automática: continuar usando qualquer produto da Meta para fins comerciais depois do aviso significa concordar [1].
Em declaração reproduzida pelo PPC Land, o porta-voz da Meta Andy Stone disse que o objetivo é obter informação precisa sobre produtos à venda em sites de terceiros para recomendar anúncios e conteúdo dentro das plataformas [2]. A mesma reportagem observa que os termos não mencionam o arquivo robots.txt, que é a forma tradicional de um site dizer aos robôs o que eles podem ler, e que o robô de treino da Meta é de uso misto, e não dedicado a uma única finalidade [2].
Por que isso importa
Para uma loja, ter o catálogo lido pela Meta pode até ajudar: o anúncio sai com o preço e a foto certos. A conta muda quando o site guarda o que a empresa produz de mais valioso, como artigos, receitas, aulas, fotos autorais e materiais técnicos. Aí o conteúdo pode alimentar um modelo de IA que depois responde as mesmas perguntas sem mandar ninguém ao seu site.
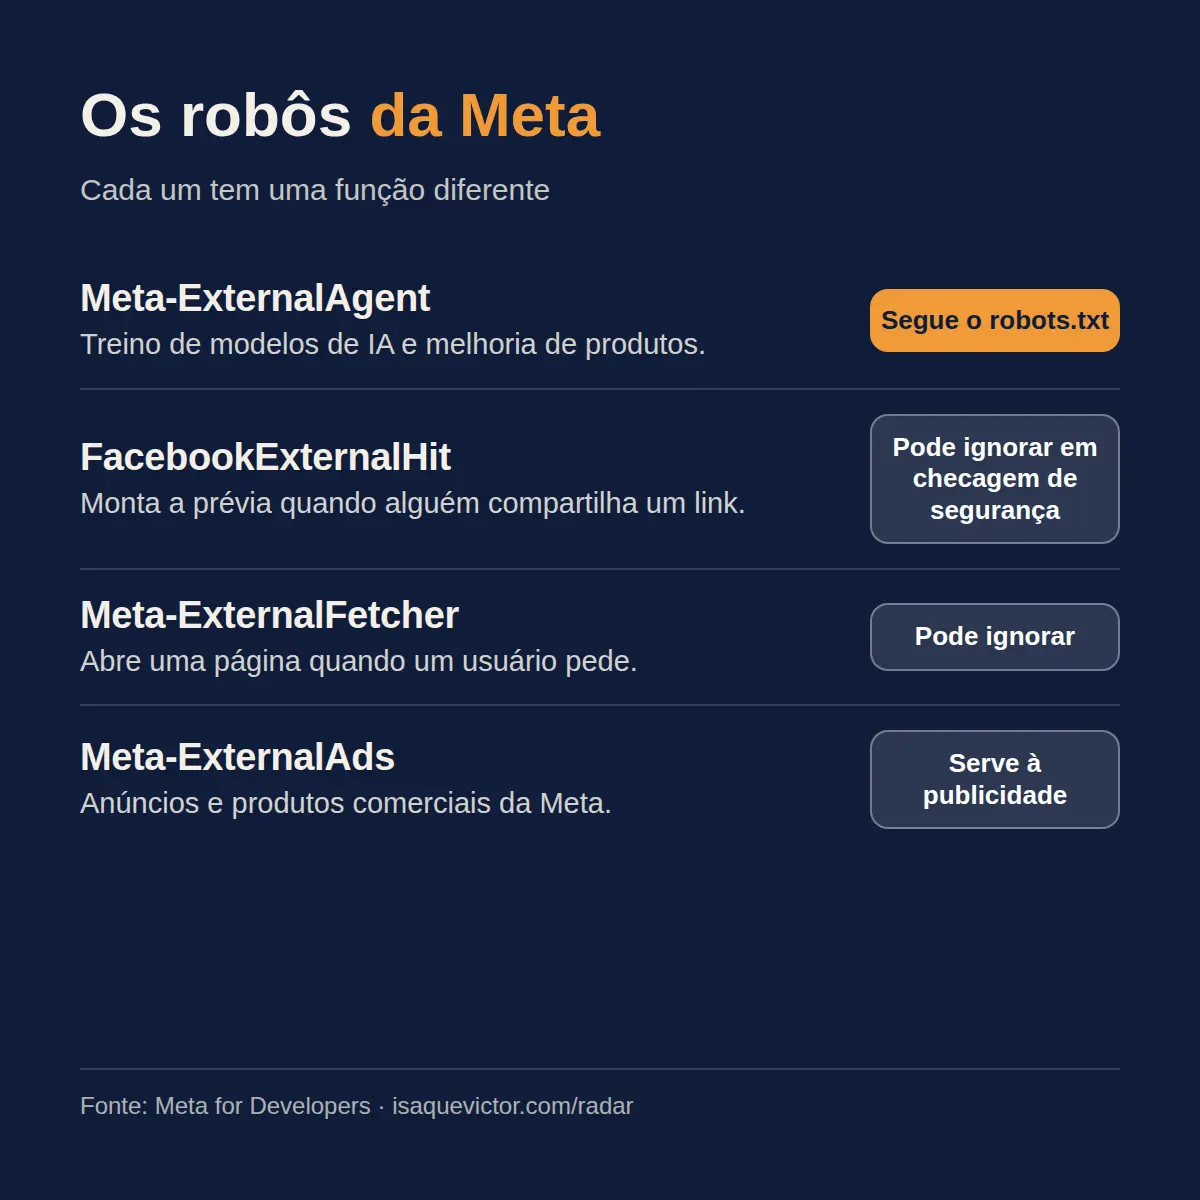
A documentação oficial da Meta ajuda a separar as coisas, porque ela tem robôs diferentes para cada função [3]. O Meta-ExternalAgent rastreia a web para casos como treinar modelos de IA e melhorar produtos, e respeita as regras do robots.txt [3]. O FacebookExternalHit monta a prévia com título e imagem quando alguém compartilha um link, e pode ignorar o robots.txt em verificações de segurança [3]. O Meta-ExternalFetcher abre uma página quando um usuário pede, e também pode ignorar o arquivo [3]. Na prática, dá para fechar a porta ao robô de treino sem perder a prévia dos seus links no WhatsApp. A Meta avisa que uma mudança no robots.txt pode levar até 24 horas para valer [3].
Fica uma dúvida que eu não consigo resolver por você: como os termos não citam o robots.txt, não está claro se o bloqueio prevalece sobre a autorização dada ao aceitar o contrato [2]. Mesmo assim, o arquivo é a ferramenta prática que existe hoje, e a própria Meta escreve que o robô de treino o segue [3].
Para fechar
A decisão aqui não é sair das redes. É saber o que o seu site entrega a quem o lê. Se você não sabe o que o robots.txt da sua empresa permite hoje, comece por ele; e se quiser ajuda para conferir, essa é uma conversa que a IV Help faz com gosto.
Na prática
O que isso muda para o seu negócio
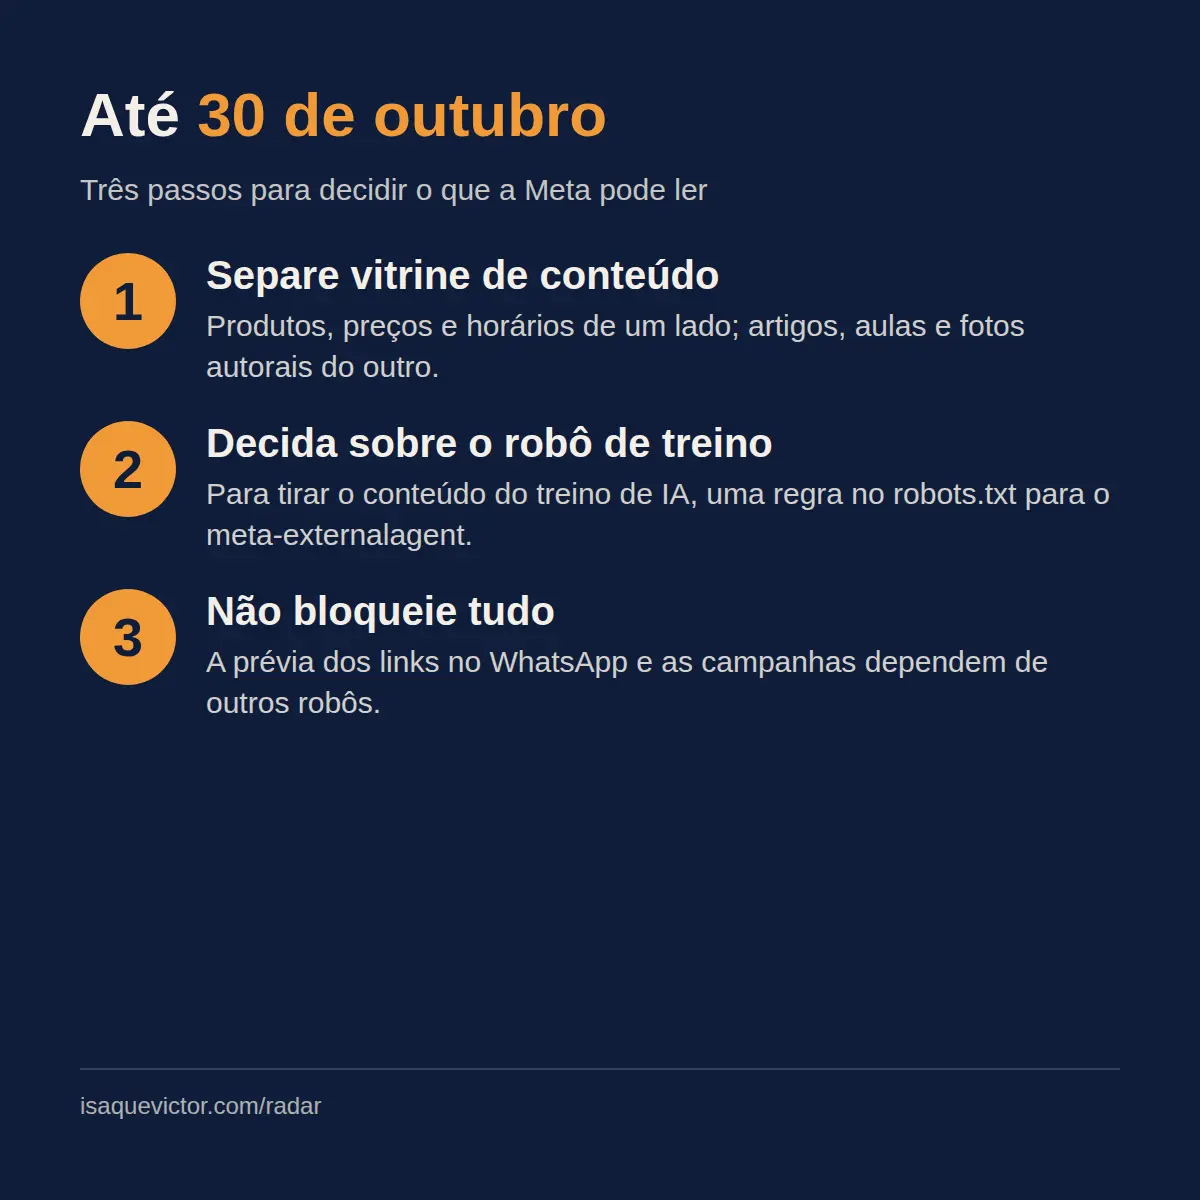
- Faça: até 30 de outubro, separe o que no seu site é vitrine (produtos, preços, horários) e o que é conteúdo próprio (artigos, aulas, fotos autorais). Se não quiser esse conteúdo no treino de IA da Meta, peça a quem cuida do site uma regra no robots.txt para o robô meta-externalagent.
- Evite: bloquear todos os robôs da Meta de uma vez. Bloquear o FacebookExternalHit tira a prévia dos seus links no WhatsApp e no Instagram, e o robô Meta-ExternalAds existe justamente para os produtos de publicidade [3], então bloqueá-lo sem necessidade pode atrapalhar as suas campanhas.
- Observe: se a Meta vai esclarecer a relação entre os termos e o robots.txt, e se o mesmo tipo de cláusula aparece nos contratos de outras plataformas que você usa para vender.
Fontes citadas
- Termos Comerciais da Meta (versão atualizada, em vigor em 30 de outubro de 2026)Meta · 17/10/2026
- Meta grants itself the right to crawl advertisers' websites for AIPPC Land · 17/10/2026
- Meta Web CrawlersMeta for Developers · 17/10/2026
- Meta Commercial Terms (updated version, effective October 30, 2026), versão em inglêsMeta · 18/10/2026
Comentários
Ainda não há comentários. Comece a conversa.